なんでもエクセル(Nandemo Excel)

何でもエクセルでやってしまう そこのあなた、ようこそ

数式/関数:DATEDIF関数を使わずに期間を計算する

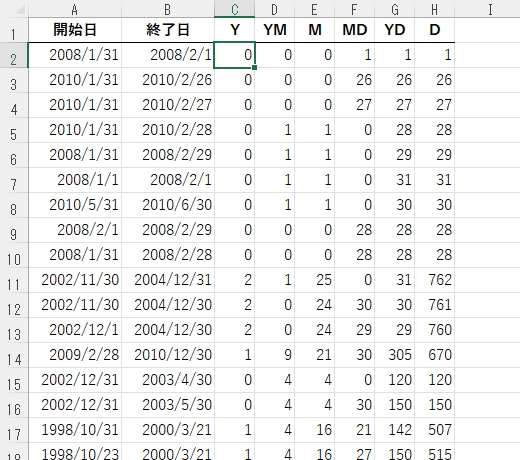
DATEDIF関数自体は便利なんですが、日本の民法準拠で計算してくれないところがところどころ見受けられます(単純にバグだと思いますが)。最近は生成AI任せでこういうのに挑戦する人も減ってしまいましたけど、法律に合わせて正しく計算すればいいだけなので、今のエクセル(2024・365)なら数式でも大して手間でもありません。計算自体は単純ですしね。

簡単なのは、名前定義で「XDATEDIF」を登録しておく方法です。

Ctrl + F3」で「名前の管理」を開き、[新規作成]で
【名前】XDATEDIF
【参照範囲】=LAMBDA(開始日,終了日,期間,[初日不参入],LET(始,開始日-1+初日不参入+ISOMITTED(初日不参入),終,終了日,始年,YEAR(始),始月,MONTH(始),始日,DAY(始),始翌日,DAY(始+1),終年,YEAR(終),終月,MONTH(終),終日,DAY(終),終翌日,DAY(終+1),基準日,DATE(終年,始月,MIN(始日,DAY(DATE(終年,始月+1,0)))),_M,終年*12+終月-始年*12-始月-IF(始翌日=1,IF(終翌日>1,1),IF(AND(終翌日>1,終日<始日),1)),_Y,INT(_M/12),_YM,MOD(_M,12),_D,終-始,_MD,IF(終翌日=1,MOD(MAX(終日-始翌日+1,0),終日),IF(始翌日=1,終日,MOD(終日-DAY(MIN(DATE(終年,終月-{1,0},始日*{1,0}))+1)+1,DAY(終-DAY(終))))),_YD,終-IF(基準日>終,EDATE(基準日,-12),基準日),CHOOSE(XMATCH(UPPER(期間),{"Y","YM","M","MD","YD","D"}),_Y,_YM,_M,_MD,_YD,_D)))
→[OK]

これで登録完了です。後はセルに下記のように入力すれば使えます。

=XDATEDIF(開始日, 終了日, 期間, [初日不参入])

具体例でいうと「=XDATEDIF(A1,B1,"MD")」みたいな感じです。

一応、初日算入/初日不算入を「TRUE/FALSE」で指定できるようにしています。省略は可能で、デフォルトは不算入です。

名前定義せずにワークシート上で使いたいなら

=LAMBDA(開始日,終了日,期間,[初日不参入],LET(
  始,開始日-1+初日不参入+ISOMITTED(初日不参入),終,終了日,
  始年,YEAR(始),始月,MONTH(始),始日,DAY(始),始翌日,DAY(始+1),
  終年,YEAR(終),終月,MONTH(終),終日,DAY(終),終翌日,DAY(終+1),
  基準日,DATE(終年,始月,MIN(始日,DAY(DATE(終年,始月+1,0)))),
  _M,終年*12+終月-始年*12-始月-IF(始翌日=1,
    IF(終翌日>1,1),IF(AND(終翌日>1,終日<始日),1)),
  _Y,INT(_M/12),
  _YM,MOD(_M,12),
  _D,終-始,
  _MD,IF(終翌日=1,MOD(MAX(終日-始翌日+1,0),終日),
    IF(始翌日=1,終日,MOD(終日-DAY(MIN(DATE(終年,終月-{1,0},始日*{1,0}))+1)+1,
    DAY(終-DAY(終))))),
  _YD,終-IF(基準日>終,EDATE(基準日,-12),基準日),
  CHOOSE(XMATCH(UPPER(期間),{"Y","YM","M","MD","YD","D"}),
    _Y,_YM,_M,_MD,_YD,_D)
))(A2,B2,"MD")

のようにして使います。末尾の「()」のところで指定すれば使えます。

Power Query:他の列を参照して列を編集する

パワークエリで「列の編集」といったら、Table.TransformColumns関数の出番ですよね。ところがこの関数、指定した列以外は参照できないという欠点があります。

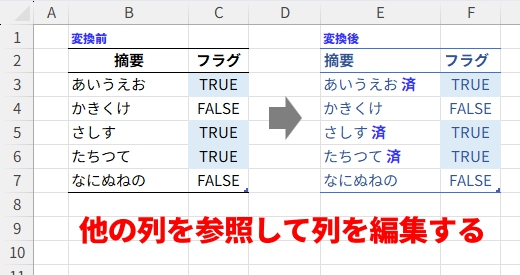
例えば、「フラグ列が『TRUE』の時にだけ、摘要列の文字列の末尾に『 済』を付けたい」という場合、Table.TransformColumn関数ではフラグ列を参照することができません。これを解決するためには別の関数を使う必要があります。

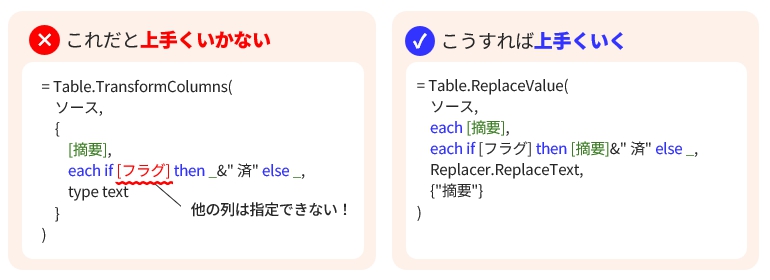
Table.TransformColumns関数ではうまくいかない理由

まずは何故うまくいかないのかを整理しておきます。

= Table.TransformColumns(
    ソース,
    {[摘要], each if [フラグ] then _&" 済" else _, type text}
)

見ての通り、Table.TransformColumns関数では、第2引数では列(摘要列)を指定しています。なので、「[フラグ]」と書いても「何ですか、それ?」となってしまいます。ここで悩んでいても解決しないので、Table.TransformColumnsを使うのはきっぱりあきらめましょう。

新規に列を作って入れ替える

ひとまずの解決方法は、「直接列を編集せず、新規列を追加して対応」です。列を直接編集できないなら新規に列を作ってしまえばいいですね。

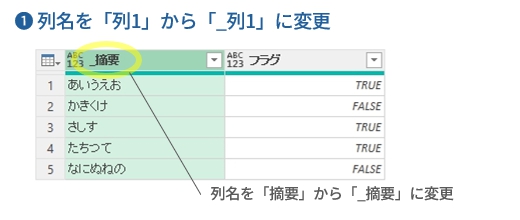
まず、新規の列を「摘要」にしたいので、元の摘要列は違う名前に変更しておきます。

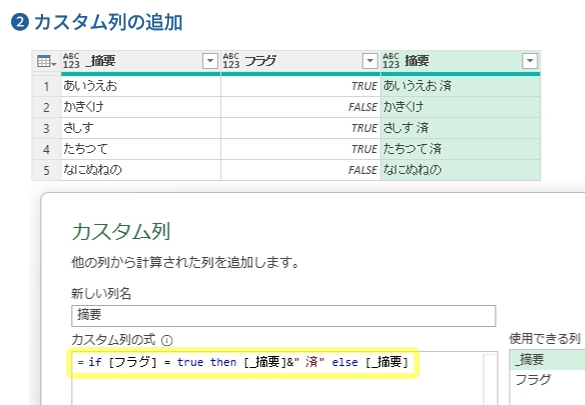
次に、新摘要列を追加します。式は「if ... then ... else」を使えばいいです。

[列の追加]→[カスタム列]
= if [フラグ] = true then [_摘要]&" 済" else [_摘要]

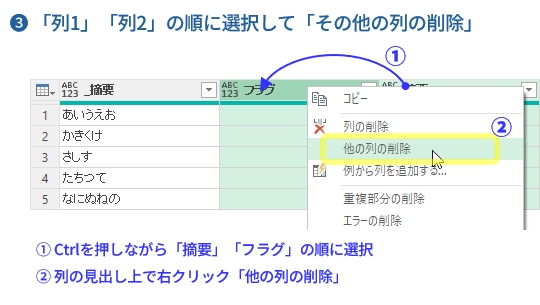
最後に「_摘要」列を削除し、列の順番を入れ替えます。

この「他の列を削除」ですが、実際には「列を選択する(Table.SelectColumns関数)」機能なので「不要な列を削除する」と「列の順番を入れ替える」を同時に実行できます。

Table.ReplaceValue関数を使って値を置き換える

メニューからマウスでポチポチと操作してももちろんいいんですが、Table.ReplaceValue関数を使えば、もっとスマートに解決できます。

= Table.ReplaceValue(
    ソース,
    each [摘要],
    each if [フラグ] then [摘要]&" 済" else [摘要],
    Replacer.ReplaceText,
    {"摘要"}
)

これでいいんです。

実はこの関数、メニューでは「値の置き換え」で使われる関数です。メニューの操作で「A」を「B」に置換すると、数式バーには

= Table.ReplaceValue(
    ソース,
    "A",
    "B",
    Replacer.ReplaceValue,
    {"摘要"}
)

のように表示されます(見やすくするために改行を入れていますが)。

先ほどの式と見比べてみるとわかりますが、異なるのは「"A"」と「"B"」のところだけですから、全部暗記したり、一から書いたりする必要はありません。

「特定の文字が含まれる値を置換する」の際にも説明しましたが、Replacer.ReplaceValue関数のところをカスタム関数に変更するなら、下のような書き方もできます。

= Table.ReplaceValue(
    ソース,
    each [フラグ],
    each _,
    (a,b,_)=> if b then a&" 済" else a,
    {"摘要"}
)

一から書くなら、こっちのほうがエクセルの数式っぽくて分かりやすいかもしれませんね。

Power Query:祝日一覧を作成する

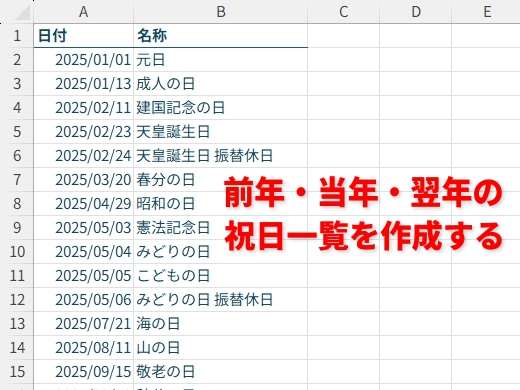
似たような記事は作っていたものの、そのものズバリは書いていませんでした。パワークエリを使って祝日一覧を作る方法です。

当年の前後3年分の祝日一覧を作成する

実務で使う場合、祝日一覧は「今年を含めた前後の1年分」あれば充分かと思います。「Holidays JP API」の WebAPIを使わせてもらえば、これは簡単に作成できます。

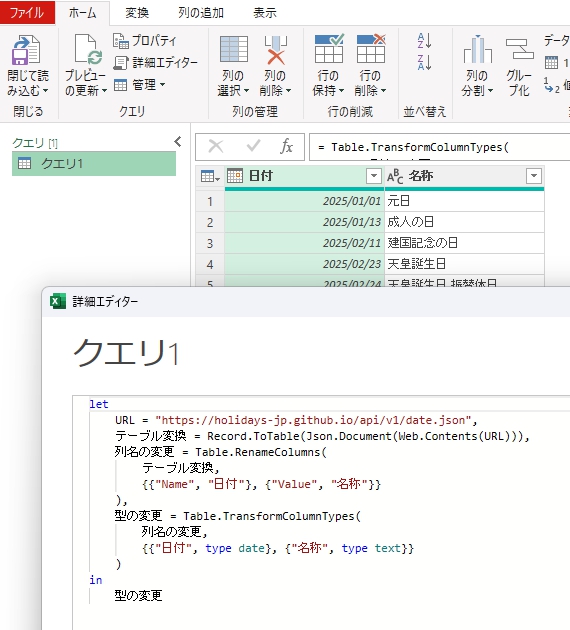
新規クエリを作成し、[ホーム]の[詳細エディター]を開いて、中身を下記のコードに書き換えるだけです。

let
    URL = "https://holidays-jp.github.io/api/v1/date.json",
    テーブル変換 = Record.ToTable(Json.Document(Web.Contents(URL))),
    列名の変更 = Table.RenameColumns(
        テーブル変換,
        {{"Name", "日付"}, {"Value", "名称"}}
    ),
    型の変更 = Table.TransformColumnTypes(
        列名の変更,
        {{"日付", type date}, {"名称", type text}}
    )
in
    型の変更

最後に「閉じてブックに読み込み」すれば、当年の前後を含めた3年分の祝日リストを呼び出せます。

特定の年の祝日一覧を作成する

やることは変わらないので、さらっといきます。指定した年の祝日リストのみを呼び出す方法です。

let
    年 = 2026,
    URL1 = "https://holidays-jp.github.io/api/v1/★/date.json",
    URL2 = Text.Replace(URL1, "★", Text.From(年)),
    テーブル変換 = Record.ToTable(Json.Document(Web.Contents(URL2))),
    列名の変更 = Table.RenameColumns(
        テーブル変換,
        {{"Name", "日付"}, {"Value", "名称"}}
    ),
    型の変更 = Table.TransformColumnTypes(
        列名の変更,
        {{"日付", type date}, {"名称", type text}}
    )
in
    型の変更

これでおしまいです。

特定の年を含めた前後3年分の祝日一覧を作成する

これもやることはそんなに変わりませんが、「2026」年を含めた前後3年分の祝日一覧を呼び出す方法です。

let
    年 = 2026,
    祝日一覧リスト = List.Transform({-1,0,1}, each [
        対象年 = 年+_,
        URL1 = "https://holidays-jp.github.io/api/v1/★/date.json",
        URL2 = Text.Replace(URL1, "★", Text.From(対象年)),
        テーブル変換 = Record.ToTable(Json.Document(Web.Contents(URL2)))
    ][テーブル変換]),
    テーブル結合 = Table.Combine(祝日一覧リスト),
    列名の変更 = Table.RenameColumns(
        テーブル結合,
        {{"Name", "日付"}, {"Value", "名称"}}
    ),
    型の変更 = Table.TransformColumnTypes(
        列名の変更,
        {{"日付", type date}, {"名称", type text}}
    )
in
    型の変更

年のところを変数にして、カスタム関数にしてもいいですね。

Power Query:SharePointフォルダからファイルに接続する

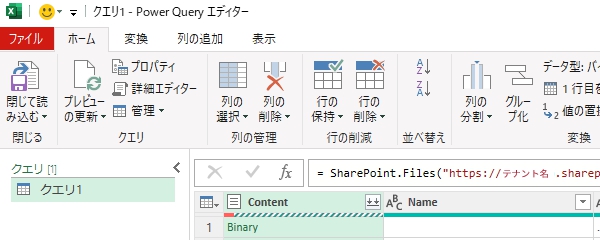
エクセルのパワークエリでSharePointのドキュメントにアクセスする場合、データ取得の「SharePoint フォルダから」を使って接続することが多いかと思います。

この方法だと、指定サイトのURLに含まれる「サブフォルダ内も含めた全てのドキュメント」が検出されますよね。ここから指定のフォルダ(の中のファイル)を探そうとすると、抽出機能を使う必要が出てきます。ドキュメント内のファイル数が多い場合、読み込んでそれを絞り込んで……にかなりの時間がかかってしまいます。

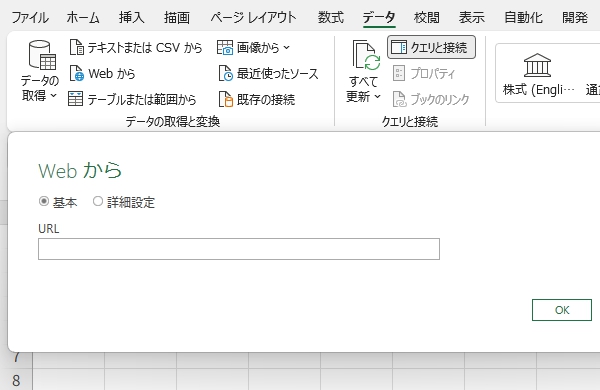
他に、データ取得の「その他のデータ ソースから」→「Webから」を選んで、直接URLを指定してファイルに接続する方法もあります。

もちろんこれでもいいんですが、SharePointの「リンクをコピーする」でURLをコピーした場合は、貼り付ける前に参照するURLを一部加工しないといけません(「https://テナント名.sharepoint.com/sites/サイト名/……/ファイル名.xlsx」のような形。その後、組織アカウントでのサインインも必要)。また直接ファイル名を指定しているので、ファイル名が変動する場合や複数のファイルを指定したい時には使えません。

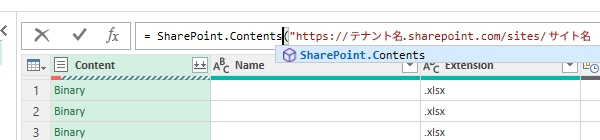
上記の2つの方法は、いずれもM関数的にはSharePoint.Files関数を使って接続しているんですが、この関数は階層をドリルダウンしながらファイルのあるフォルダまで移動していくのには向いていません。エディタ画面上で操作する前提なら、SharePoint.Contents関数に切り替えるのがお勧めです。

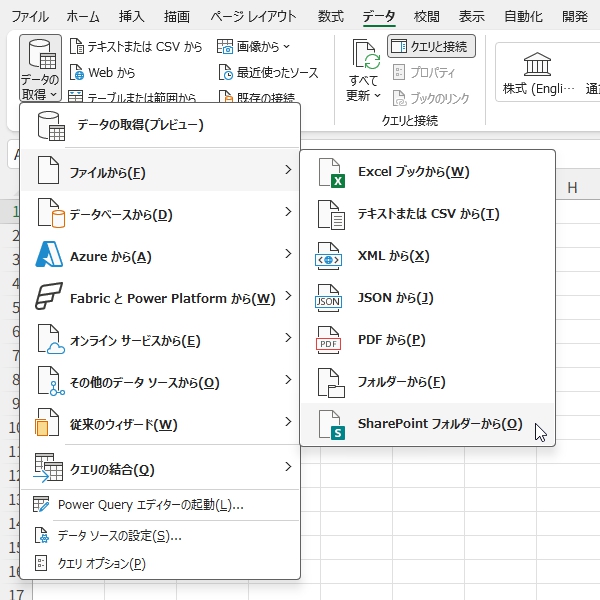
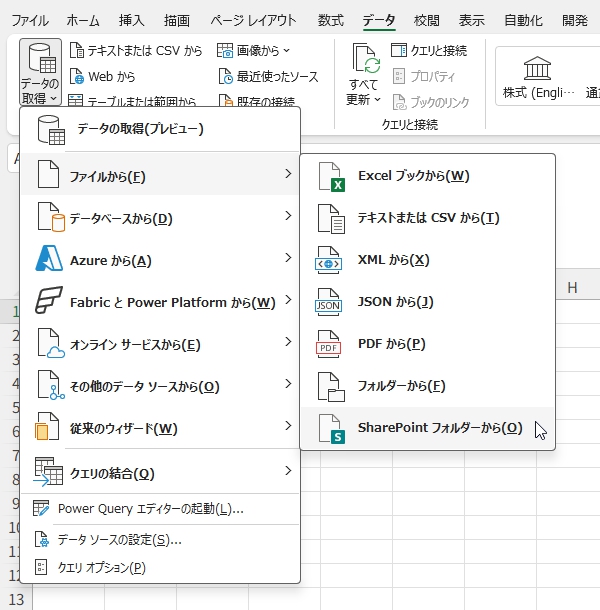
「SharePoint フォルダから」接続する

まずは普通に接続します。

  [データ]→[データの取得]→[ファイルから]
  →[SharePoint フォルダから]

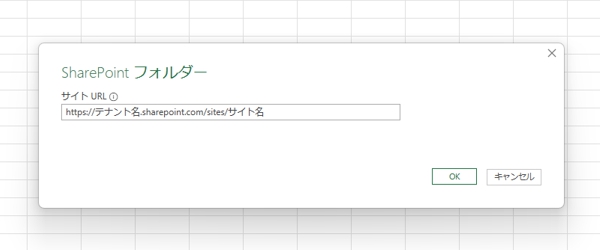
  サイトURLに「https://テナント名.sharepoint.com/sites/サイト名」を入力
  →[OK]
  →[データの変換]をクリック

すると「Poewr Query エディター」の画面が開きます。


もしサイトURLが分からない場合は、SharePointを起動してそこでサイト名を検索し、開いたサイトのトップページのURLをコピーしてください。

エディター画面で関数名を書き換える

数式バーを見てもらえばわかる通り、この状態では関数が「 SharePoint.Files」関数になっています。これを「 SharePoint.Contents」関数に書き換えます。

パワークエリのいいところのひとつに「接続しているデータを壊す心配がない」ことがあります。失敗したらやり直せばいいだけなので安心して進めてください。

learn.microsoft.com

階層をドリルダウンして指定のフォルダへ移動する

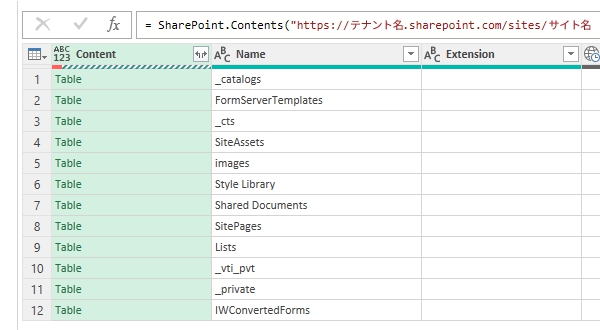
関数名を「SharePoint.Contents」に書き換えると、表示されていたテーブルの構成が変わります。この関数では、サブフォルダ以下のドキュメントは表示対象から外れます。

ここから「Name」列のフォルダ名の左横にある「Table」を順番にクリックしていくことで、フォルダの階層を下っていくことができます。

例えば「Shared Document」フォルダから「親」→「子」→「孫」フォルダ、と階層を下って移動したい場合は

「Name」列「Shared Documents」の「Content」列の「Table」をクリック
「親」の左横の「Table」をクリック
「子」の左横の「Table」をクリック
「孫」の左横の「Table」をクリック

のように操作することで階層を移動できます。詳細エディタで確認すると、コードは下記のようになります。

    #"Shared Documents" = ソース{[Name="Shared Documents"]}[Content],
    親 = #"Shared Documents"{[Name="親"]}[Content],
    子 = 親{[Name="子"]}[Content],
    孫 = 子{[Name="孫"]}[Content]

最後に指定ファイルが表示されている行の「Binary」をクリックすれば、目的のテーブルを開けます。「Contents」列の右にある「↓↓」ボタンを押すことで、「ファイルから」→「フォルダから」で操作しているファイルの統合の操作に繋げることもできます。

エクスプローラーでフォルダを移動していく感覚に近いので、こっちのほうが感覚的に操作しやすいと思います。SharePoint.Folder関数(でファイルを抽出する)より全体としての読み込みも早くなるはずなので、「どうもSharePointフォルダから接続すると時間がかかり過ぎる」という場合は一度お試しください。

数式/関数:A列とB列を比較して抽出する

例えば、A列とB列のデータを比較して、「A列にだけあるデータ」「B列にだけあるデータ」「A列とB列の両方にあるデータ」を抜き出したい時、どんな方法を思い浮かべるでしょうか。色んな方法がありますが、今回は数式でやる方法をまとめてみました。

後半では関数化する方法や、まとめて表示する方法についても触れています。
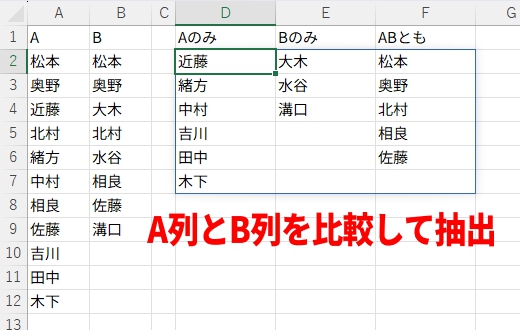
一応最初に書いておきますが、今回のデータ(A・B)は「それぞれの範囲内での重複は省いてある」ものとします。

COUNTIF関数を使う方法

おそらく真っ先に思い浮かぶ方法ではないかと思います。というのも「『範囲1』にあって『範囲2』にないデータの抽出」は単純には、

=FILTER(範囲1,COUNTIF(範囲2,範囲1)=0)

これで済むからです。

とはいえこれだけでは色々問題が起きます。「範囲1」を列範囲で指定してしまうと、猛烈に計算が重くなりますし、「範囲1」と「範囲2」のどちらかに全くデータがない時、この数式のままでは不具合が起きます。そこで少し数式を補強します。

「範囲1」にあって「範囲2」にないデータを抽出(COUNTIF関数の場合)
=LAMBDA(範囲1,範囲2,   IFERROR(IF(ISERR(@範囲2),範囲1,FILTER(範囲1,COUNTIF(範囲2,範囲1)=0)),"") )(DROP(A:.A,1),DROP(B:.B,1))

TRIM参照(「:.」とすることで不要な下位行を省く)とDROP関数(第二引数で指定した行数だけ上位行を削除する)を使うことで、純粋なデータ範囲のみを指定できます。また「ISERR(@範囲2)」で「範囲2」のデータがない場合のエラーをチェックして、条件分岐しています。

TRIM参照は今のところ、Microsoft365限定なので、Excel2024の場合は

=LAMBDA(範囲1,範囲2,
  IFERROR(IF(ISERR(@範囲2),範囲1,FILTER(範囲1,COUNTIF(範囲2,範囲1)=0)),"")
)(DROP(TOCOL(A:A,1),1),B:B)

のようにしてください。実のところ、COUNTIF関数は最終行を取得してから計算する関数なので、「範囲2」のほうは列参照のままでも問題ありません。

「『範囲2』にあって『範囲1』にないデータの抽出」は、それぞれの参照を逆にすればいいですし、「両方の範囲にあるデータの抽出」は「=0」のところを「<>0」もしくは「>0」とすればいいです。
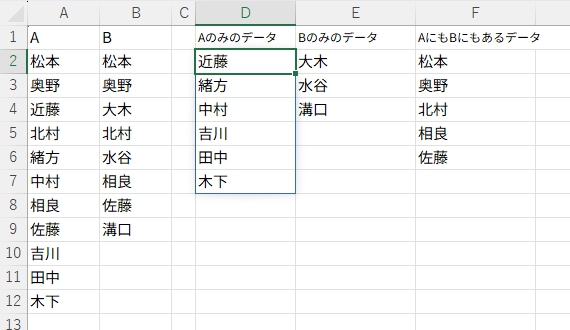
「範囲2」にあって「範囲1」にないデータを抽出(COUNTIF関数の場合)
=LAMBDA(範囲1,範囲2,   IFERROR(IF(ISERR(@範囲1),範囲2,FILTER(範囲2,COUNTIF(範囲1,範囲2)=0)),"") )(DROP(A:.A,1),DROP(B:.B,1))
「範囲1」にも「範囲2」にもあるデータを抽出(COUNTIF関数の場合)
=LAMBDA(範囲1,範囲2,   IFERROR(IF(ISERR(@範囲2),範囲1,FILTER(範囲1,COUNTIF(範囲2,範囲1)>0)),"") )(DROP(A:.A,1),DROP(B:.B,1))

UNIQUE関数を使う方法

COUNTIF関数の替わりにUNIQUE関数を使う方法もあります。COUNTIF(もしくはCOUNTIFS)関数は、第一引数にセル範囲しか入れることができません。配列を入れられないので、応用したい時に不便な場合があります。

UNIQUEにはそのような制限がありません(ただしVSTACK関数を使っているので、Excel2021以前のバージョンでは使えません)。

「範囲1」にあって「範囲2」にないデータを抽出(UNIQUE関数の場合)
=LAMBDA(範囲1,範囲2,   IFERROR(IF(ISERR(@範囲2),範囲1,UNIQUE(VSTACK(範囲1,範囲2,範囲2),,TRUE)),"") )(DROP(A:.A,1),DROP(B:.B,1))

UNIQUE関数は第3引数を「TRUE」にすることで、「重複していない値」のみを表示します。COUNTIF関数と違って、第1引数にセル範囲だけでなく配列を入れることもできます。そこで、VSTACKで「範囲1」と「範囲2」を縦結合して、その配列の中から「重複していない値」を抽出しているわけです。

「範囲2」にあって「範囲1」にないデータを抽出(UNIQUE関数の場合)
=LAMBDA(範囲1,範囲2,   IFERROR(IF(ISERR(@範囲1),範囲2,UNIQUE(VSTACK(範囲2,範囲1,範囲1),,TRUE)),"") )(DROP(A:.A,1),DROP(B:.B,1))
「範囲1」にも「範囲2」にもあるデータを抽出(UNIQUE関数の場合)
=LAMBDA(範囲1,範囲A,   IFERROR(UNIQUE(VSTACK(範囲1,範囲A,範囲A),,TRUE),"") )(DROP(A:.A,1),D2#)

この方法を応用することで「重複している値」だけを表示させることもできます。

抽出条件を切り替えできる関数を作る

注意:ここから先は応用です。別に読まなくても問題ありません。

ここまでの数式をよく見てみると、どの数式もそれほど違いがないことに気づくのではないでしょうか。「こことここ以外は同じ」と分かったらしめたもので、その「ここ」を変数にして関数化してしまいましょう。
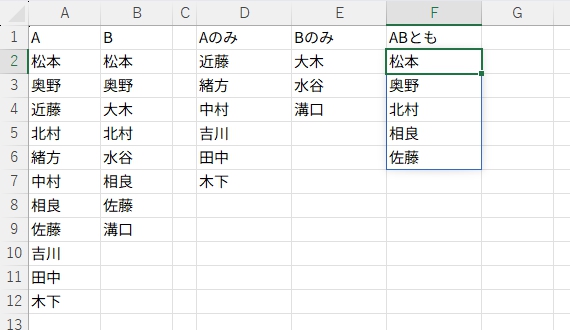
抽出条件を指定して切り替える関数(COUNTIF関数の場合)
=LAMBDA(範囲1,範囲2,指定,LET(   f,LAMBDA(a,b,c,d,IFERROR(IF(ISERR(@b),c,FILTER(a,COUNTIF(b,a)+d=1)),"")),   Aのみ,f(範囲1,範囲2,範囲1,1),   Bのみ,f(範囲2,範囲1,範囲2,1),   ABとも,f(範囲1,範囲2,"",0),   CHOOSE(指定,Aのみ,Bのみ,ABとも) ))(DROP(A:.A,1),DROP(B:.B,1),★)

「★」に「1」~「3」を入力することで、抽出条件が「Aのみ」「Bのみ」「ABとも」と切り替わります。同様にUNIQUE関数でもやってみます。

抽出条件を指定して切り替える関数(COUNTIF関数の場合)
=LAMBDA(範囲1,範囲2,指定,LET(   f,LAMBDA(a,b,c,IFERROR(IF(ISERR(@b),a,UNIQUE(VSTACK(a,b,b),,TRUE)),"")),   Aのみ,f(範囲1,範囲2,範囲1),   Bのみ,f(範囲2,範囲1,範囲2),   ABとも,f(範囲1,Aのみ,""),   CHOOSE(指定,Aのみ,Bのみ,ABとも) ))(DROP(A:.A,1),DROP(B:.B,1),★)

これも「★(1~3)」で抽出条件が「Aのみ」「Bのみ」「ABとも」と切り替わっていきます。

条件指定に配列を使えるようにする

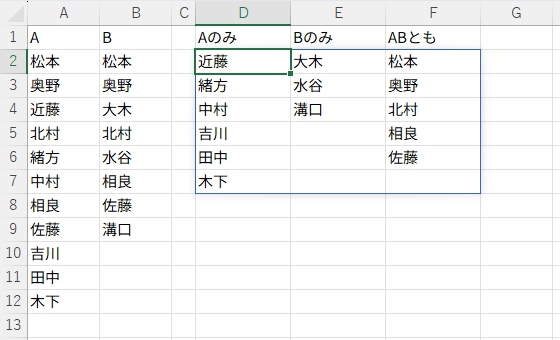
ここから更に応用してみます。先ほどの数式の「★」を複数列指定できるようにして、一度に表示できるようにしてみましょう。
=LAMBDA(範囲1,範囲2,[指定],LET(
  f,LAMBDA(a,b,c,d,IFERROR(IF(ISERR(TAKE(b,1)),c,FILTER(a,COUNTIF(b,a)+d=1)),"")),
  Aのみ,f(範囲1,範囲2,範囲1,TRUE),
  Bのみ,f(範囲2,範囲1,範囲2,TRUE),
  ABとも,f(範囲1,範囲2,"",FALSE),
  列選択,IF(ISOMITTED(指定),{1,2,3},指定),
  データ,IFERROR(CHOOSECOLS(HSTACK(Aのみ,Bのみ,ABとも),列選択),""),
  IFERROR(FILTER(データ,BYROW(データ,LAMBDA(x,OR(x<>"")))),"")
))(DROP(A:.A,1),DROP(B:.B,1),{1,2,3})

これで「1」のように指定することもできますし、表示させる条件列を「{1,2}」のように配列で指定することもできます。どうせなので、UNIQUE関数のほうでもやってみます。

=LAMBDA(範囲1,範囲2,[指定],LET(
  f,LAMBDA(d,[tf],IFERROR(UNIQUE(d,,IF(ISOMITTED(tf),TRUE,tf)),"")),
  a,f(範囲1,FALSE),b,f(範囲2,FALSE),
  結合,VSTACK(a,b),重複,f(結合),
  Aのみ,f(VSTACK(結合,b)),Bのみ,f(VSTACK(結合,a)),
  ABとも,f(VSTACK(a,重複,重複)),
  列選択,IF(ISOMITTED(指定),{1,2,3},指定),
  データ,IFERROR(CHOOSECOLS(HSTACK(Aのみ,Bのみ,ABとも),列選択),""),
  IFERROR(FILTER(データ,BYROW(データ,LAMBDA(x,OR(x<>"")))),"")
))(DROP(A:.A,1),DROP(B:.B,1))

因みに第3引数を省略した場合は、3条件を全て表示させる仕様になっています。

「こんな長々とした式、使いづらいじゃないか」と思うかもしれませんが、LAMBDA関数の式は名前定義しておくことで、そのブック上では関数として使用できます。今回の数式を「INTERSECT」のような名前で関数として定義しておけば、実際のセル上では、

=INTERSECT(DROP(A:.A,1),DROP(B:.B,1))

とするだけでよくなります。
Power Query:シート名一覧(目次シート)を作成する

1つのブックにシートを大量に作成するのは避けたいところですが、基のデータがそうなっている場合はどうしようもありません。シート数が何十枚単位になってくると、先頭に目次シートを作りたくなることもあるかと思います。今回はパワークエリを使って、シート名一覧(とその横にシートへのリンク)を作る方法をご紹介します。

シートの選択(目次機能)を使う

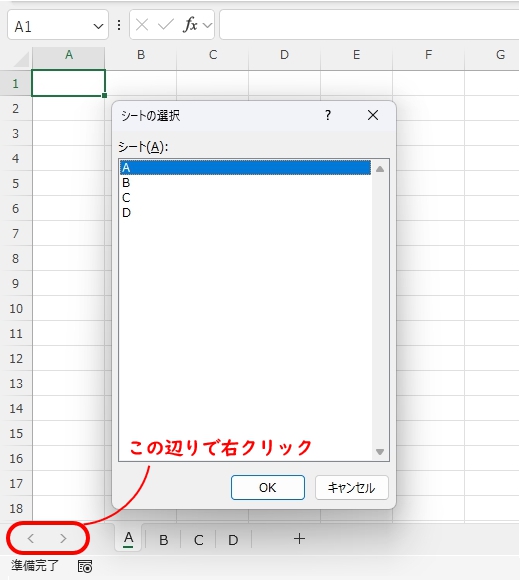
一応先にご紹介だけしておきますが、いちいち目次シートを作らなくてもエクセルには「シートの選択」という目次機能があります。これで済むなら一番効率がいいですね。

シート見出しが並んでいる左側の「<」「>」の辺りを右クリックすると「シートの選択」ダイアログが開きます。ここで指定のシートを選んで「OK」すれば、そのシートにジャンプすることができます。「これでいいや」という人は、この後の記事を読む必要はありません。

ブックに接続する

「シートの選択」機能で済むなら簡単なのですが、毎回その操作をするのが難しい場合もあるでしょう。そんな時に使えるのが、パワークエリによるシート名一覧の呼び出しです。

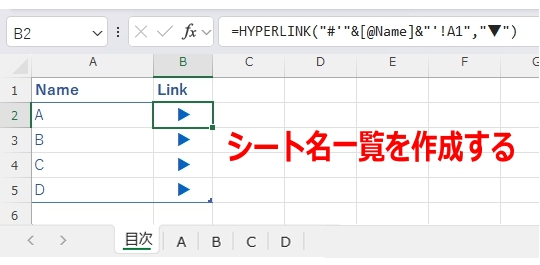
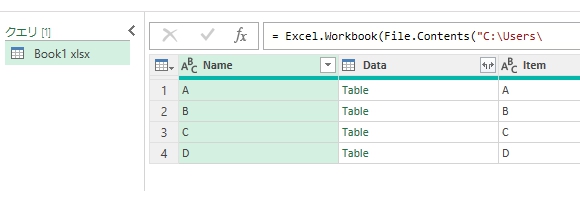
上記の画像のように、今回のサンプルファイルは「目次」「A」「B」「C」「D」の5シートからなる構成です。ここから「目次」を除く「A」「B」「C」「D」を呼び出して一覧として表示させます。

まずは当該ファイル(以下「自ブック」)に接続します。

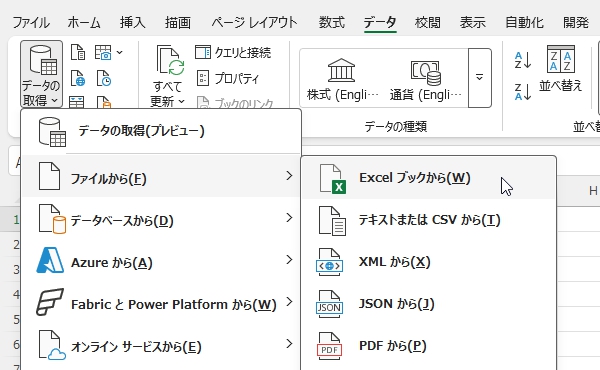
[データ]→[データの取得]→[ファイルから]
→[Excel ブックから]

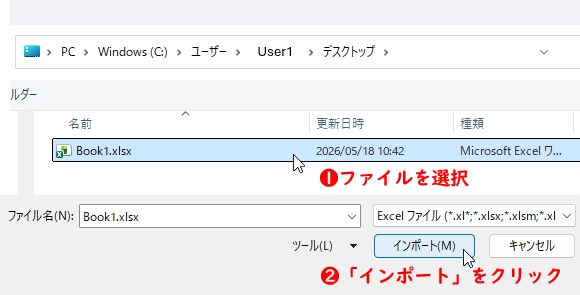
①ファイルを選択
②「インポート」をクリック

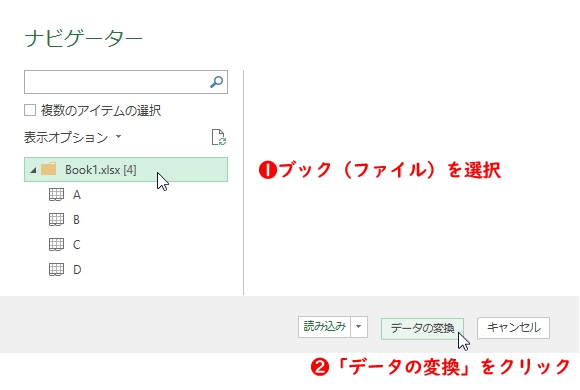
①ブック(ファイル)を選択(今回の場合は「Book1.xlsx)
②「データの変換」をクリック

すると、Power Queryエディタが開いて、自ファイルのファイル情報テーブルに接続されます。

SharePoint上のファイルの場合は「Excel ブックから」ではなく「SharePoint フォルダーから」を選択して、別途ファイルを絞り込む作業が発生しますが、やることはそれほど変わりません。

不要な行を除外する

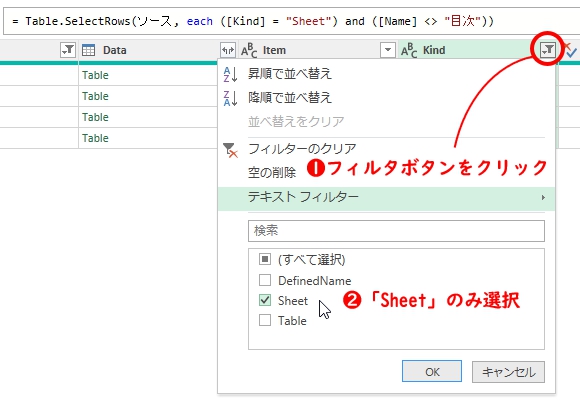
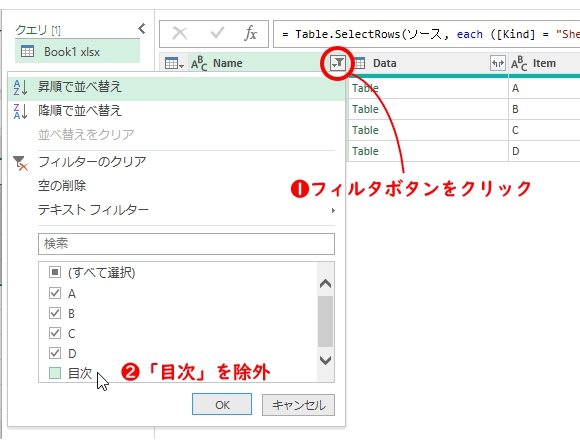
ファイル情報には接続できましたが、このままだと、不要なもの(テーブル情報や印刷範囲の設定など)が含まれてしまいますので、シート以外の情報を除外してやります。ついでなので「目次」シートも取り除いてしまいましょう。

「Kind」列のフィルタボタンをクリック
「Sheet」のみを選択して「OK」

「Name」列のフィルタボタンをクリック
「目次」のチェックを外して「OK」

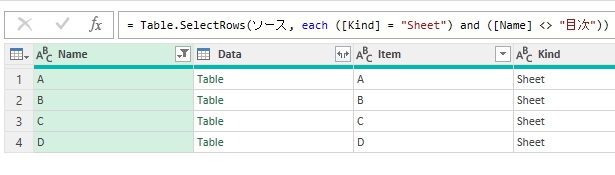
これで必要なシート名のみが表示される状態になりました。

不要な列を除外する

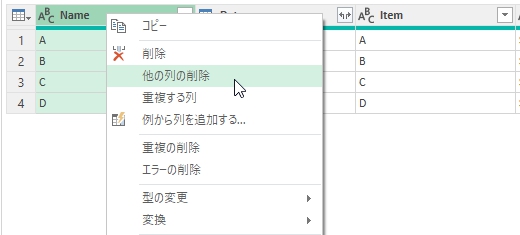
最後にいらない列を削除します。とはいえ、「いらない列」を1つずつ選択する必要はありません。今回必要なのは「Name」列のみですから、「必要な列」だけを選択して「それ以外の列」を削除するほうが簡単です。

「Name」列を右クリックして「他の列の削除」を選択してください。これでいらない列を一括で削除できます。

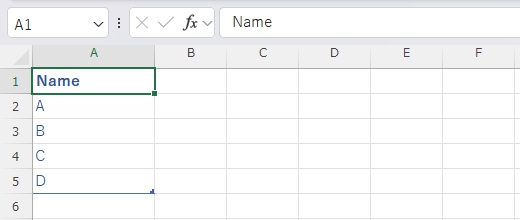
これでエディタ画面で必要な編集は終了です。作ったクエリをブックに読み込んでしまいましょう。

ホームの「閉じて読み込む」→「閉じて次へ読み込む」

ここからブックの操作に戻ります。

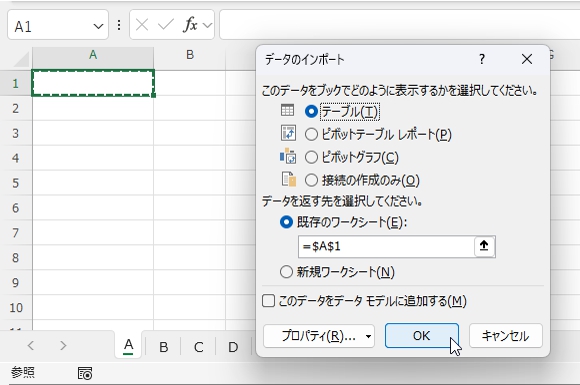
「データのインポート」ダイアログ上で、
[既存のワークシート]を選択し(上で「テーブル」を選んでいる必要があります)
データを読み込むセル(今回はA1)を指定して[OK]

ここまでくれば後はリンクを作っておしまいです。

各シートへのリンクを作成する(数式)

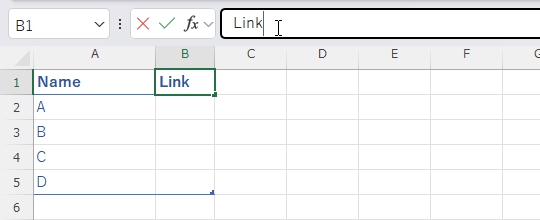
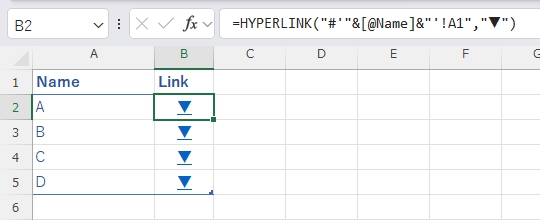
読み込んだテーブルに「Link」列を追加します。といってもこれは簡単で、B1上で「Link」と入力するだけで、勝手にテーブルに列が追加されます。

列が追加されたら、そこに下記の数式を入力します。

=HYPERLINK("#'"&[@Name]&"'!A1","▼") 

以上です。

これで「▼」をクリックすれば、指定のシートにジャンプするようになります。
「え、じゃあ先頭の目次シートへはどうやって戻ればいいの?」という方もいるかもしれませんが、その場合は

この画像の左端の「<」を「Ctrl」キーを押しながらクリックすれば先頭シートに戻れます。

ここまでで、ひとまずやるべきことはおしまいです。後は見た目を調整するくらいですね。

いちいちマウスで操作するのは面倒という方のために接続用のコードの付けておきます。これをコピーしてURLやFilePathを変更すれば、そのまま使えます。

ファイルへの接続
let FilePath = "C:\……\Book1.xlsx", //ここにファイルパスを入力 ソース = Excel.Workbook(File.Contents(FilePath), null, true), 行の抽出 = Table.SelectRows( ソース, each [Kind]="Sheet" and [Name]<>"目次" ), 列の選択 = Table.SelectColumns(行の抽出, {"Name"}) in 列の選択
SharePointフォルダからの接続
let URL = "https://…….sharepoint.com/sites/……", //ここにサイトURLを貼る ソース = SharePoint.Files(URL, [ApiVersion = 15]), ファイルの選択 = Table.SelectRows( ソース, each [Folder Path] = URL & "/Shared Documents/★/" //★にフォルダパスを入れる and [Name]="Book1.xlsx" ), Excelブック = Excel.Workbook(ファイルの選択{0}[Content]), 行の抽出 = Table.SelectRows( Excelブック, each [Kind]="Sheet" and [Name]<>"目次" ), 列の選択 = Table.SelectColumns(行の抽出,{"Name"}) in 列の選択

おまけ:見た目を整える

ついでなので見た目を調整します。「テーブル スタイル」についてはお好みのものを選択してください。私はいつもオプションの「フィルターボタン」や「縞模様(行)」のチェックは外してしまいます。

列幅の自動調整や、悪さばかりする書式の保持も切ってしまいます。

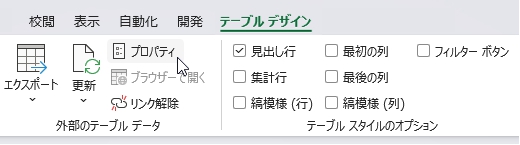
[テーブルデザイン]→外部テーブル データの「プロパティ」
[列の幅を調整する]と[セルの書式を保持する]のチェックを外す

これをしておかないと、何かにつけて更新の際に書式が元に戻ってしまいます。

ついでのついでで、フォント名の頭に「@」を付けます(「游ゴシック」なら「@游ゴシック」に変更)。これで字が反時計回りに90度回転します。

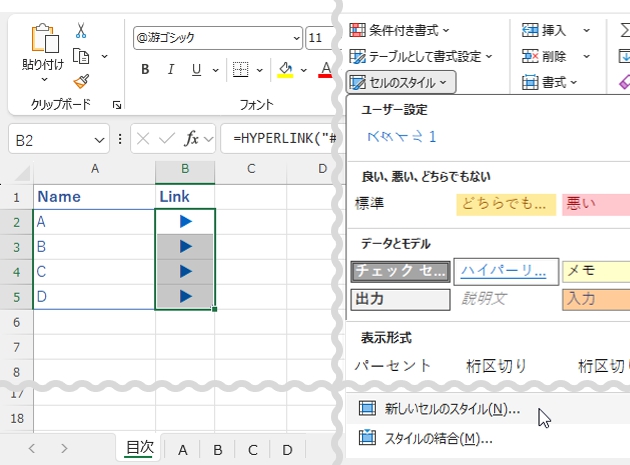
ついでのついでのついでに、この書式を「セルのスタイル」に登録しておきます。

[ホーム]→[セルのスタイル]→[新しいセルのスタイル]
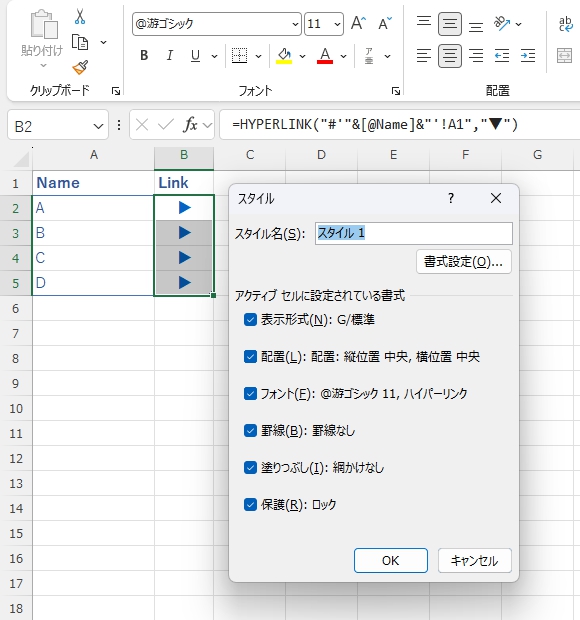
「スタイル1」を「リンク」に変更して[OK]

こうしておけば何かの拍子に設定がおかしくなっても、セルのスタイルで「リンク」を選択すれば簡単に元に戻せます。

数式/関数:置換リストを使って一括で置き換える

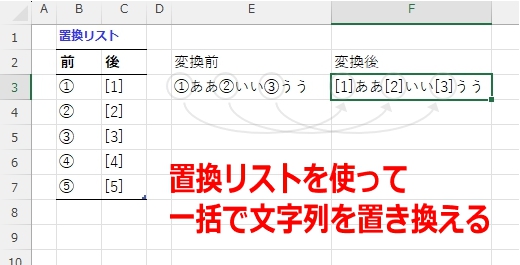
「置換リストを使って一括で文字列を置き換えたい」って要望は、昔からよくあるんですよね。下の画像の場合、「『①』を『[1]』に置き換えて、『②』は『[2]』に置き換えて……」を繰り返して、E3の値をF3のように一括で置換する方法です。

SUBSTITUTE関数によるネスト

昔は SUBSTITUTE関数のネスト(入れ子)で対応するしかなかったので、大変でした。

=SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(
E3,B3,C3),B4,C4),B5,C5),B6,C6),B7,C7)

こんな感じのやつです。置換するものが更に増えたら、ものすごいことになってしまいます。大昔(Excel2003まで)は関数のネストは7個まで(現在は 63まで)という縛りがあったので、数が増えると名前の定義と組み合わせるなどの工夫が必要でした。

もちろん現在の Excelではこんなことはしなくていいです。

REDUCE関数による一括置換 その1

Excel2024以上であれば REDUCE関数が使えます。

=REDUCE(E3,SEQUENCE(ROWS(テーブル1)),LAMBDA(x,y,SUBSTITUTE(x,
INDEX(テーブル1[前],y),INDEX(テーブル1[後],y))))

だいぶすっきりしましたね。

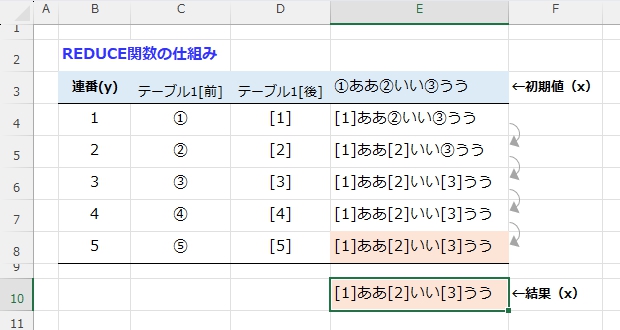
REDUCE関数の仕組みについては、下の画像を見てもらえばわかりやすいのではないかと思います。

つまり、初期値「x」に「y」の順番に計算を実行して、その最終結果だけを残しています。このように、REDUCE関数を使うことで「置換する数だけ関数をネストする」ような運用は避けられるようになります。
REDUCE関数による一括置換 その2

上の方法でもちろんいいんですが、「INDEX(テーブル1[前],y)」や「INDEX(テーブル1[後],y)」の部分が、少しだけ気になります。いちいち連番を作らないといけないのはなんとなく面倒です。REDUCEの第二引数に複数の値を保持させられないものでしょうか。それができれば、もっと単純な計算になるはずです。

そこで2つ目の方法です。同じく REDUCE関数を使いますが、第二引数に MAP関数を入れます。
=REDUCE(E3,MAP(テーブル1[前],テーブル1[後],LAMBDA(a,b,LAMBDA(x,
SUBSTITUTE(x,a,b)))),LAMBDA(x,f,f(x)))

数式の長さはそれほど変わりませんが、SEQUENCE関数を使わなくてよくなりましたし、最後の SUBSTITUTE関数の計算がかなりすっきりしました。

MAP関数で使う複数の値(「a」と「b」)を関数に入れ込んだことで、REDUCE関数に受け渡しできるように加工しています。

見やすくなるよう、LETで関数部分を定義するとこうなります。

=LET(
  f,LAMBDA(a,b,LAMBDA(x,SUBSTITUTE(x,a,b))),
  REDUCE(E3,MAP(テーブル1[前],テーブル1[後],f),LAMBDA(x,fx,fx(x)))
)

受け渡しの関数を外に出したことで、REDUCE関数がよりシンプルになりましたね。

関数の説明(カリー化とLAMBDAコンテナ)

以下必要ないかもしれませんが、先ほどの数式の説明です。見た目と違ってかなり複雑なことをやっていますので、無理に読まなくても大丈夫です。

通常、SUBSTITUTE関数は「対象」「検索文字列」「置換文字列」の3つの引数を一度に必要としますが、関数「f」ではこれを2段階に分けています。

関数「f」は「a(テーブル1[前])」と「b(テーブル1[後])」の2つの変数を受け取って「文字列を置換する関数」を返しています。そして、この関数は「x(対象文字列)」を受け取ることを前提としています。

※関数の引数の受け取りを複数の関数に分解して、連鎖的に呼び出すように変換する手法を「カリー化」と呼びます。関数型のプログラミング言語ではよく使われます。

今回は MAP関数の内部で、「『x』を受け取って『a』を『b』に置換する関数」を作っています。これによって、MAP関数の戻り値は、「a」と「b」をペアとした「f」関数の配列になります。

この関数を REDUCE関数内で処理することで、「a」と「b」の2つの値を受け取って「x」を置換できるようにしています。

正直なところ無理して覚える必要はないんですが、知っていると応用できる範囲が広がります。